
简介
Project Gutenberg 是一个走公版路线的电子书库,只收美国版权已经过期的作品,把老书逐页数字化后免费开放下载与在线阅读。做阅读类内容站、书单号、翻译与教辅素材的人常把它当无授权成本的底本库:经典小说、哲学、科学史、词典、诗集都在里面,整理成栏目或做翻译底稿都不用先谈授权。它替代的是「去商业书店找公版书、再自己核版权」这条弯路,代价是内容偏老、偏英文。
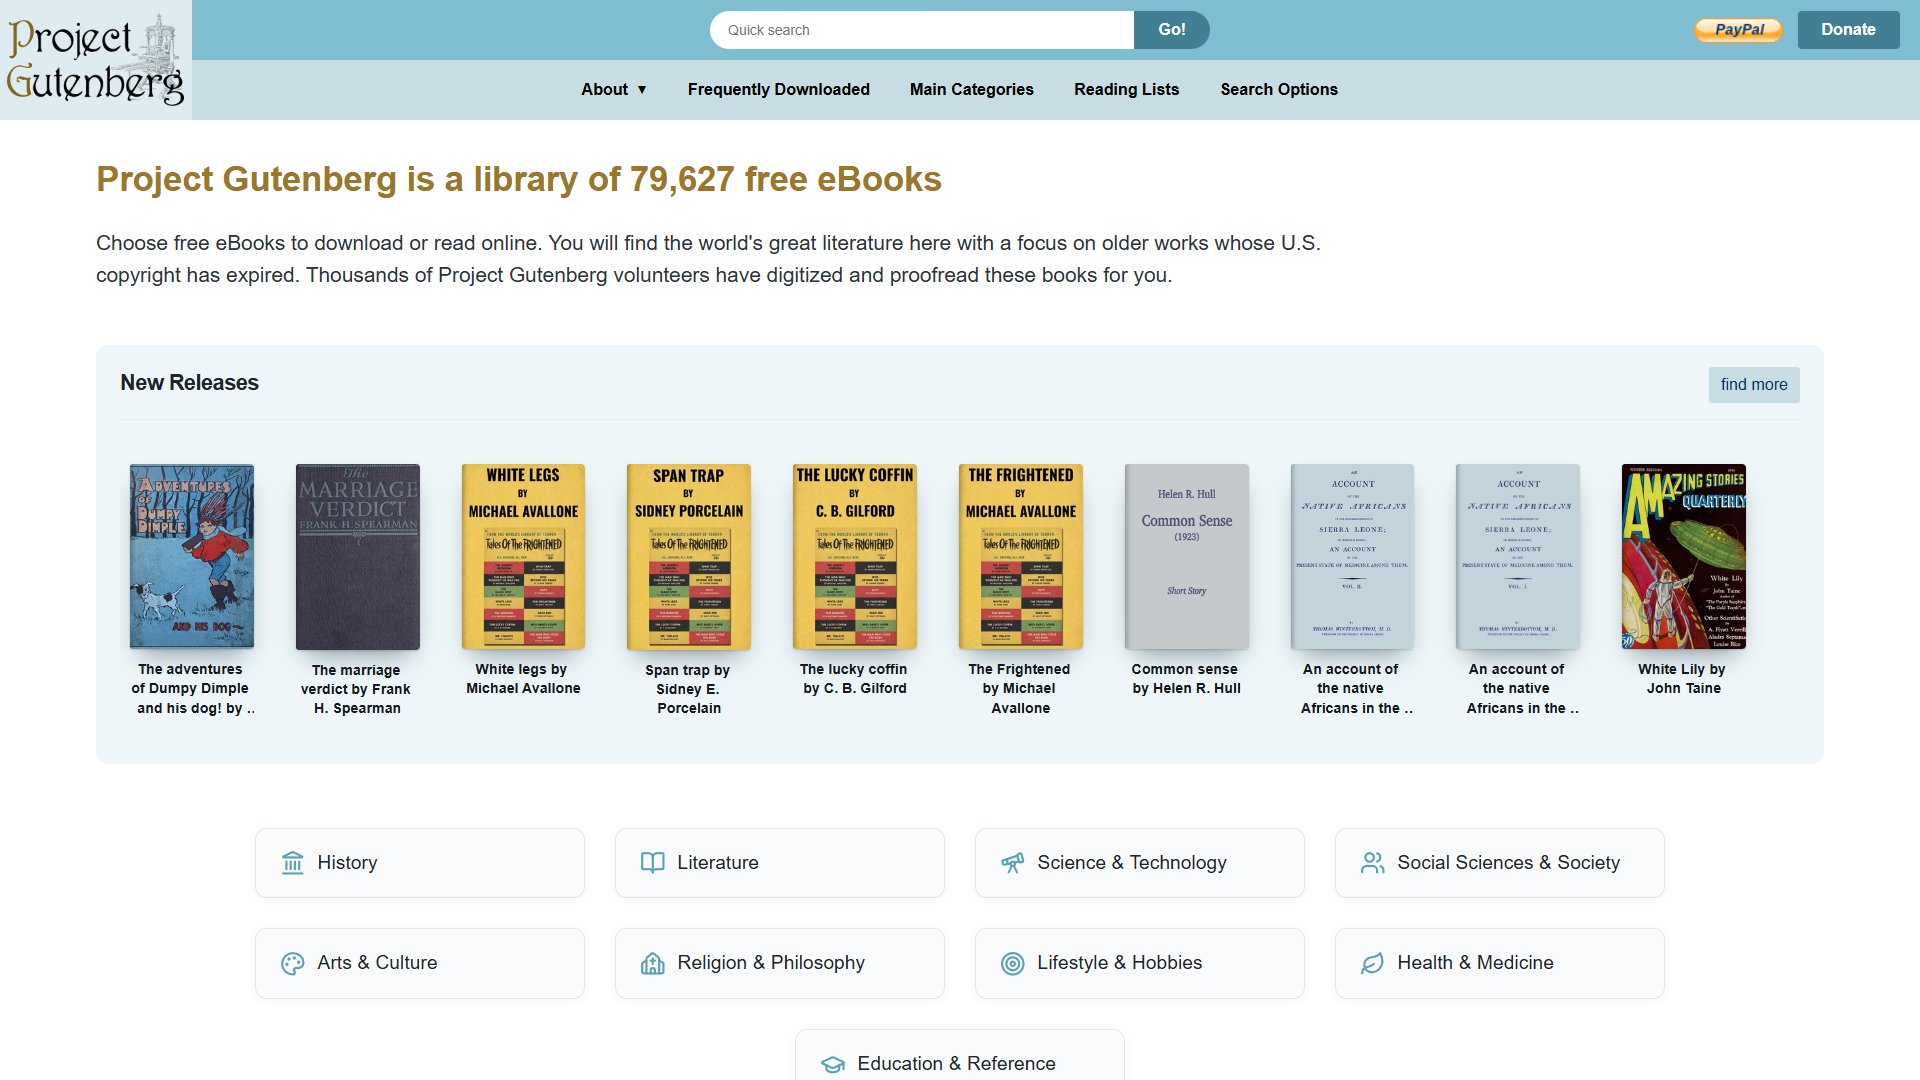
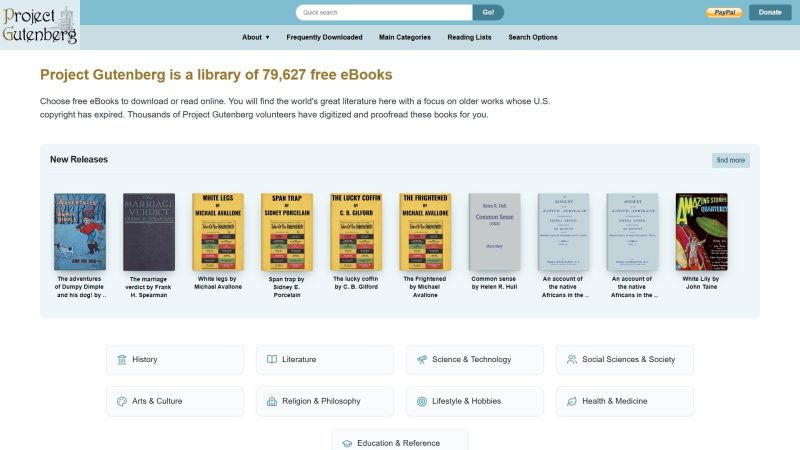
库的存量是 79,627 册,从 1971 年起已经做了 55 年以上,全部免费、无需注册、也不用装 App。选书入口按九个学科大类铺开,从 History、Literature 到 Health & Medicine、Education & Reference,书页里再挂 Reading ease score、LoC Class、Subject 这些图书馆级编目字段,可以按难度和学科筛,而不只看书名。值得用的场景很具体:要一批版权干净、能长期挂在自己站上的书目;不适合的场景也一样具体:找当代作品、中文原创或需要阅读进度同步的人。
适用人群
最适合做阅读类内容站、书单号、翻译与教辅素材的人:公版书没有授权谈判成本,存量足够撑起按作者、按学科、按难度编目的栏目。也适合只想往阅读器里塞几本经典自用的人,EPUB3 直接下,不需要注册。反过来,要找当代畅销书、中文原创或带语音同步的阅读体验,不必在这里耗时间——它只收版权过期的老书,语种以英文为主;只是偶尔读一两本经典的人,用浏览器在线阅读就够,站内也没有任何付费档需要权衡。
优缺点
- ✅ 全站免费、免注册,浏览器打开就能读或下载,没有试用期、额度与广告打断。
- ✅ 收录的是美国版权已过期的作品,做书单、翻译底本、公版素材二次整理时版权顾虑小。
- ✅ 存量深:词典、诗集、地方志、科学史这类商业渠道买不到的老书,这里常常能找到全本。
- ✅ 页面是纯 HTML,没有账号体系与前端框架依赖,弱网、老电脑和阅读器内置浏览器都能打开。
- ❌ 界面停在上一代排版,没有推荐算法、阅读进度同步与收藏夹,选书只能靠分类与榜单。
- ❌ 语种以英文为主,书名、作者、主题都是英文原字段,找中文书或当代作品基本落空。
使用方法
- 起步不设门槛:直接打开站点,不需要注册、登录或付费,搜索框输入书名、作者或 ISBN 就能进书页,eBook-No. 也能直接定位;需要批量取数时才要先看它对机器人访问的规则。
- 核心动线在书页的 Download for free 区块:首选 EPUB3(附 Recommended for most devices 字样与 23.7 MB 的体积);要放进 Kindle 就走 Send-to-Kindle,Kobo、Nook 用 USB 传输,手机与电脑用阅读 App 打开。
- 老设备或需要探究版本,去同一区块的 Other formats & older devices,里面另有非 EPUB 格式;下载前先看书页里的 Last Update,旧文本修订过的书重下一次更划算。
- 进阶落地:把 Top 100 榜单(书榜与作者榜,可切昨日 / 7 天 / 30 天)当选题池,用脚本把书名、作者、近 30 天下载量整成自己的书单页;也可把 Feeds of New Books 接进内容流,新上架书目自动进待写队列。
- 注意两个限制:榜单与下载量每天在变,引用数字时要把取数日期一起写进页面;公版判定只算美国版权,作者逝世年份与本国版权状态仍需自己再核一遍。
收费说明
完全免费,没有付费档。全站不设订阅、不卖会员,也不要求账号:书可以整本下载、在线阅读、再分发(在美国版权已过期的前提下),唯一的商业入口是捐赠,55 年来的数字化工作靠志愿者与捐款维持,建站与服务器费用不向读者摊。两个需要注意的地方:免费不等于无约束,公版只覆盖美国版权已过期的作品,其它司法辖区的版权状态要单独核;站点不做商用授权背书,把它当素材源做付费产品时,版权链要自己走完。
平台支持
形态是网站与在线应用,不需要安装客户端,也没有官方 App:普通浏览器就能在线阅读,下载下来的 EPUB3 丢进 Kindle、Kobo、Apple Books、Calibre 这类阅读器即可。国内可以直接打开,不必自备代理,页面以纯 HTML 输出,正文直接在页面里,弱网下也能读到。登录方式:没有账号体系,也就不存在强制 Google 或 Apple 登录的问题。移动端用手机浏览器即可;站内没有桌面端与离线包,需要批量取数时按它对机器人访问的规则自行限速。
截图